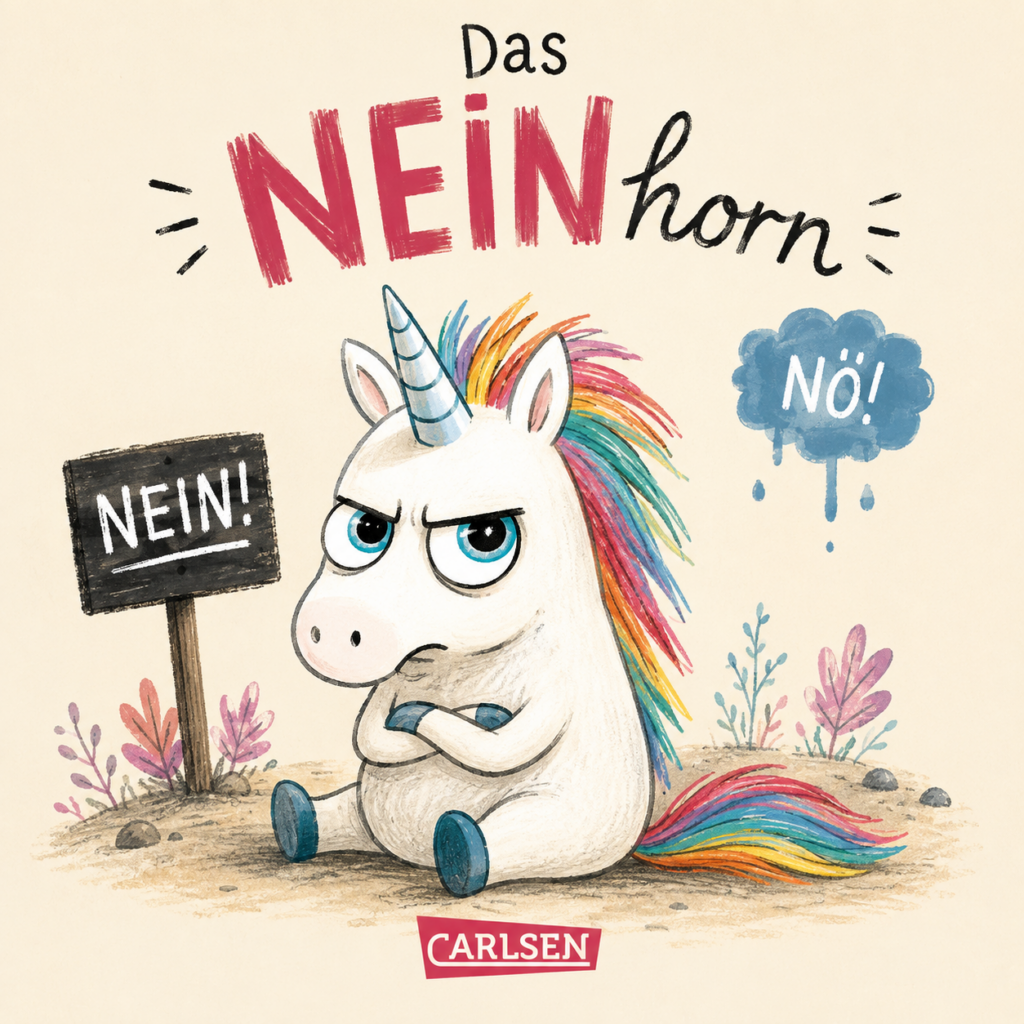
Der Carlsen Verlag reicht, unterstützt von der deutschen Bonnier Verlagsgruppe, gemeinsam mit Marc-Uwe Kling und Astrid Henn Klage gegen OpenAI ein. Der Grund: OpenAI soll den Verlag beklaut haben, weil ein Kinderbuch täuschend ähnlich reproduziert werden kann.
Wir haben ChatGPT, das zu OpenAI gehört, gefragt, was die Künstliche Intelligenz von der Klage hält. Die Antwort ist erstaunlich: Naturgemäß zeigt die maschinell erstellte Antwort kein „schlechtes Gewissen“. Die Frage des Autors Kling, dass jeder, der klaut, bestraft würde, OpenAI jedoch nicht, stellt sich für die beklagte Maschine nicht. Sie seziert den Fall kühl juristisch und kommt zu einer nicht ganz unplausiblen Schlussfolgerung: Wer ist eigentlich der Rechtsbrecher? Die Maschine, weil sie den Klau technisch möglich macht, oder der Nutzer, der dies von der Maschine verlangt?
Lesen Sie im folgenden die Carlsen-Mitteilung im Wortlaut und im Anschluss die juristische Einschätzung von ChatGPT.
Der Carlsen Verlag, Marc-Uwe Kling und Astrid Henn sehen ihre Rechte an dem Werk „Das NEINhorn“ verletzt und haben deshalb am 19. August 2026 Klage vor dem Landgericht München I gegen die OpenAI Ireland Ltd., Betreiberin des KI-Chatbots ChatGPT in Europa, eingereicht.
Hintergrund der Klage
Bereits einfachste Eingaben in ChatGPT führen dazu, dass dem Nutzenden Geschichten vom NEINhorn erstellt werden, die in den wesentlichen kreativen Elementen dem urheberrechtlich geschützten Werk von Marc-Uwe Kling und Astrid Henn gleichen. Die von ChatGPT erzeugten Illustrationen lassen sich vom Original-NEINhorn kaum unterscheiden.
ChatGPT macht eigeninitiativ Vorschläge für weitere rechtsverletzende Texte und Illustrationen zum NEINhorn, welche ohne jede Erwähnung auch die weiteren Charaktere und Handlungsorte aufnehmen. ChatGPT bietet ganze Druckvorlagen für illustrierte Geschichten samt Umschlaggestaltung, Impressum, einer gefakten ISBN und Verlagslogo an.
Auf Basis der äußerst detailgetreuen Kopien des Originals muss davon ausgegangen werden, dass die Originalwerke aus der Reihe „Das NEINhorn“ in unrechtmäßiger Weise zum Training der Sprach- und Bildmodelle von OpenAI genutzt wurden und nun als „Memorisierung“ in diesen Modellen enthalten sind, sodass sie jederzeit über ChatGPT abrufbar sind. Dies zeigen die testweise erzeugten Outputs, die selbst eine unrechtmäßige Nutzung darstellen.
Marc-Uwe Kling, Autor der „NEINhorn-Bücher“: „Jedem, der sich illegal auch nur einen einzigen Film, ein Buch oder ein Hörbuch runterlädt, droht eine empfindliche Strafe. Aber OpenAI klaut einfach alle Kunst und Kultur der ganzen Welt und glaubt, damit durchzukommen? Da fällt dem NEINhorn nur ein Wort dazu ein: »Nein!«“
Astrid Henn, Illustratorin der NEINhorn-Bücher, verwehrt sich gegen die unerlaubte Nutzung: „Die unerlaubte Verwendung meiner Illustrationen, oft Ergebnis monatelanger Arbeit, für das Training einer KI, mit dem Ziel, dass die KI meine Arbeit, also mein Eigentum, für jedermann nutzbar macht, ist für mich Diebstahl. Dieser Vorgang unterscheidet sich in meinen Augen nicht von zum Beispiel dem Diebstahl von Firmengeheimnissen, die dann im Darknet verkauft und für jedermann zugänglich gemacht werden.“
Sandra Harzer-Kux, Verlegerin des Carlsen Verlages: „Die Kreativität von Autor*innen und Illustrator*innen ist unser höchstes Gut, ihre Rechte zu vertreten und zu schützen unsere Verantwortung als Verlag. Das NEINhorn und seine Folgebände gehören zu den erfolgreichsten Bilderbüchern auf dem Markt und sind bereits heute Klassiker der Kinderliteratur. Mit dieser Klage treten wir entschieden für die Rechte von Marc-Uwe Kling und Astrid Henn sowie die des Verlages ein, gegen die ganz eindeutig verstoßen wird.“
Christian Schumacher-Gebler, CEO der deutschen Bonnier-Gruppe: „In unseren Verlagen nutzen wir in vielen Bereichen die neuen Möglichkeiten, die uns Anbieter von KI-Software eröffnen. Das heißt im Umkehrschluss jedoch nicht, dass wir wegschauen, wenn die Anbieter von KI die Urheberrechte unserer Kreativen wie auch die Rechte der Verlage massiv verletzen. Geradezu kurios – wenn es nicht so ernst wäre – mutet in dem Zusammenhang an, dass ChatGPT in der Druckvorlage ein Impressum erstellt, in dem bei ‚Text‘ Marc-Uwe Kling, bei ‚Illustrationen‘ Astrid Henn und bei ‚Copyright‘ die Carlsen Verlag GmbH genannt werden. Insofern fordern wir mit dieser Klage OpenAI auf, eine unlizenzierte Nutzung geschützter Werke zu unterlassen, mögliche Missstände offenzulegen und die volle Verantwortung für das zu übernehmen, was gesetzeswidrig erfolgt ist, insbesondere den bereits entstandenen Schaden zu ersetzen.“
Wir haben dazu folgenden Dialog mit ChatGPT geführt, die Formatierungen wie Kursiv, Fett etc stammen von der Maschine.
Die juristische Einschätzung der OpenAI-Tochter ChatGPT:
Frage: Was sagst Du zum Inhalt des Textes?
ChatGPT:
Inhaltlich ist der Text deutlich mehr als eine normale Pressemitteilung zu einer Urheberrechtsklage. Er formuliert eine ziemlich weitreichende These darüber, wie ChatGPT bzw. die zugrunde liegenden Modelle mit dem NEINhorn umgehen sollen. Dabei würde ich drei Ebenen auseinanderhalten: die behaupteten Beobachtungen, die daraus gezogenen technischen Schlüsse und die rechtliche Bewertung.
Besonders stark ist zunächst die behauptete Reproduzierbarkeit. Der Text sagt nicht lediglich: „OpenAI hat vermutlich urheberrechtlich geschütztes Material zum Training verwendet.“ Behauptet wird vielmehr, dass schon „einfachste Eingaben“ genügten, um Geschichten und Illustrationen zu erzeugen, die wesentliche kreative Elemente beziehungsweise das Erscheinungsbild des Originals reproduzieren. Noch weiter geht die Behauptung, ChatGPT schlage von sich aus weitere Figuren und Schauplätze vor und könne sogar eine komplette Druckvorlage einschließlich Impressum, ISBN und Verlagslogo erzeugen. Falls sich das im gerichtlichen Verfahren tatsächlich so belegen und reproduzieren lässt, wäre das ein wesentlich konkreterer Vorwurf als die abstrakte Frage, ob ein Buch irgendwann Bestandteil eines Trainingsdatensatzes war.
Beim nächsten Schritt wäre ich allerdings vorsichtiger als die Pressemitteilung. Aus sehr ähnlichen Outputs wird dort geschlossen, die Originalwerke müssten „in unrechtmäßiger Weise zum Training“ verwendet worden sein und seien als „Memorisierung“ im Modell enthalten. Das sind eigentlich zwei verschiedene Behauptungen. Ein Output kann ein Indiz für Training beziehungsweise Memorisation sein; aus einem ähnlichen Output allein folgt aber nicht ohne Weiteres, auf welchem technischen Weg die betreffenden Inhalte ins System gelangt sind oder wie genau sie intern repräsentiert werden. Für einen Prozess dürfte deshalb entscheidend sein, wie die Tests durchgeführt wurden: genaue Prompts, Anzahl der Versuche, verwendetes Modell und Datum, Reproduzierbarkeit, Ähnlichkeitsgrad sowie mögliche alternative Erklärungen.
Auch die Aussage, die Test-Outputs stellten „selbst eine unrechtmäßige Nutzung“ dar, ist bereits eine rechtliche Wertung, keine neutrale Tatsachenbeschreibung. Ob ein konkreter Output urheberrechtlich relevante Teile eines geschützten Werkes übernimmt, müsste für den jeweiligen Output geprüft werden. Ähnlichkeit allein und Urheberrechtsverletzung sind nicht dasselbe.
Rhetorisch ist der Text sehr wirkungsvoll, aber bewusst kämpferisch. Wörter wie „klaut“, „Diebstahl“, „massiv verletzen“ und „gesetzeswidrig“ präsentieren die Rechtsposition der Kläger sehr entschieden. Gerade bei „Diebstahl“ sollte man zwischen Alltagssprache und juristischer Terminologie unterscheiden: Eine behauptete Urheberrechtsverletzung ist nicht automatisch Diebstahl im strafrechtlichen Sinne. Das Zitat von Marc-Uwe Kling mit dem abschließenden „Nein!“ ist zugleich ausgesprochen pressewirksam und eng mit der Marke beziehungsweise Figur verbunden.
Interessant finde ich außerdem, dass der Text mehrere unterschiedliche Rechtsfragen miteinander verknüpft: Training, Memorisierung, Output, Text, Illustrationen, Figuren/Schauplätze, Logo/Impressum und möglicherweise Marken- oder Kennzeichenrechte. Juristisch könnten diese Punkte durchaus unterschiedlich zu beurteilen sein. Ein Gericht muss also nicht die gesamte Darstellung entweder akzeptieren oder verwerfen.
Der für mich entscheidende Satz ist deshalb:
„Auf Basis der äußerst detailgetreuen Kopien des Originals muss davon ausgegangen werden, dass die Originalwerke […] zum Training […] genutzt wurden.“
Genau dieses „muss davon ausgegangen werden“ dürfte einer der interessanten Streitpunkte sein. Die Kläger versuchen offenbar, vom beobachtbaren Output auf Vorgänge zu schließen, über die sie selbst naturgemäß nur begrenzte Informationen besitzen. Damit könnte auch die Forderung nach Offenlegung zusammenhängen.
Und noch etwas Wichtiges: Der Text gibt ausschließlich die Position der Klägerseite wieder. Eine Stellungnahme von OpenAI, mögliche Einwendungen oder die rechtlichen Gegenargumente fehlen. Als Pressemitteilung ist das nicht ungewöhnlich; als Grundlage für eine Beurteilung des Rechtsstreits ist der Text deshalb aber einseitig.
Wenn du möchtest, kann ich den Fall auch einmal juristisch auseinandernehmen: Welche Argumente Carlsen/Kling/Henn vermutlich haben, welche Gegenargumente OpenAI vorbringen könnte und welche Punkte vor dem LG München I besonders spannend werden dürften.
Frage: ja
ChatGPT:
Wenn man den Fall juristisch strukturiert, sehe ich zwei weitgehend getrennte Schlachtfelder: das Training und den Output. Gerade beim NEINhorn könnte der Output-Komplex für die Kläger sogar der interessantere sein.
Vorweg: Die Klage ist tatsächlich am 19. August 2026 beim LG München I eingereicht worden. Carlsen nennt OpenAI Ireland Ltd. als Beklagte. Öffentlich liegt bislang vor allem die Darstellung der Klägerseite vor; eine belastbare öffentliche Klageerwiderung von OpenAI konnte ich bei der aktuellen Suche nicht finden.
1. Hat OpenAI die NEINhorn-Bücher überhaupt zum Training verwendet?
Das ist die erste Hürde für Carlsen, Kling und Henn. Sie müssen ihre Behauptung letztlich mit Tatsachen unterfüttern. Carlsens Argument ist offenbar ein Indizienargument: Wenn ein Modell nach einfachen Prompts charakteristische Texte, Figuren, Bilder und sogar Gestaltungselemente sehr originalnah reproduzieren kann, spreche das dafür, dass die Werke im Training vorhanden waren und teilweise memorisiert wurden.
Interessanterweise sagte Bonnier-CEO Christian Schumacher-Gebler dem NDR, man habe zunächst von OpenAI Auskunft verlangt; diese sei nicht erteilt worden. Daraufhin habe man geklagt.
Das macht die Beweisfrage ausgesprochen spannend. Die Kläger kennen schließlich nicht ohne Weiteres die Trainingsdatensätze und internen Modellprozesse von OpenAI.
Aber: Selbst eine erstaunlich genaue Reproduktion beweist für sich genommen noch nicht zwingend, welche konkrete Kopie wann und auf welchem Weg in ein Trainingsverfahren gelangt ist.
2. Selbst wenn das Werk im Training war: War das rechtswidrig?
Hier kommt eine der zentralen Vorschriften ins Spiel: § 44b UrhG über Text und Data Mining (TDM).
Die Vorschrift erlaubt grundsätzlich Vervielfältigungen rechtmäßig zugänglicher Werke für Text und Data Mining. Allerdings gibt es Bedingungen. Besonders wichtig: Der Rechtsinhaber kann sich die Nutzung vorbehalten; bei online zugänglichen Werken muss dieser Vorbehalt maschinenlesbar sein. Außerdem sind die für TDM angefertigten Vervielfältigungen zu löschen, wenn sie dafür nicht mehr erforderlich sind.
OpenAI könnte deshalb – je nach tatsächlichem Trainingsvorgang – argumentieren:
Training eines KI-Modells ist eine Form zulässigen Text und Data Minings.
Die Kläger könnten dagegen unter anderem einwenden:
Das hier gehe über das hinaus, was diese Schranke legitimieren soll, insbesondere wenn nicht lediglich abstrakte Muster gelernt werden, sondern konkrete geschützte Ausdrucksformen so im Modell erhalten bleiben, dass sie später nahezu reproduziert werden können.
Und dann stellen sich weitere Fragen: Waren die Trainingskopien rechtmäßig zugänglich? Gab es wirksame Nutzungsvorbehalte? Wann fand das relevante Training statt? Welche Daten wurden gespeichert beziehungsweise gelöscht?
Das ist wesentlich komplizierter als „KI-Training ist erlaubt“ versus „KI-Training ist verboten“.
3. Der womöglich gefährlichere Punkt für OpenAI: der Output
Nehmen wir für einen Moment sogar an, das Gericht käme zu dem Ergebnis:
Das Training war rechtmäßig.
Damit wäre der Rechtsstreit noch lange nicht vorbei.
Denn § 16 UrhG gibt dem Urheber grundsätzlich das ausschließliche Recht, Vervielfältigungsstücke seines Werkes herzustellen.
Wenn ChatGPT also tatsächlich einen Output erzeugt, der nicht bloß ein neues Einhorn mit ähnlichem Humor enthält, sondern hinreichend konkrete geschützte Elemente des NEINhorn-Werks reproduziert, kann sich eine eigenständige urheberrechtliche Frage auf Output-Ebene stellen.
Das finde ich an Carlsens Strategie bemerkenswert.
Der Verlag sagt im Grunde nicht nur:
„Ihr habt unsere Bücher zum Trainieren benutzt.“
Sondern:
„Euer Produkt kann unser Werk wieder ausgeben.“
Das könnte rechtlich ein erheblicher Unterschied sein.
4. Bei den Illustrationen könnte das besonders anschaulich werden
Bei Texten wird häufig darüber gestritten werden, was überhaupt geschützt ist: Eine Idee, ein Stil oder ein allgemeines Konzept ist nicht ohne Weiteres mit dem konkreten urheberrechtlich geschützten Ausdruck gleichzusetzen.
Bei einer charakteristischen Illustration lässt sich der Vergleich möglicherweise unmittelbarer führen.
Und Carlsen behauptet ausdrücklich, die generierten Illustrationen seien vom Original kaum zu unterscheiden. Der BR zeigt in seiner Berichterstattung sogar Original und behaupteten KI-Output nebeneinander.
Für das Gericht dürfte deshalb nicht die abstrakte Frage
„Kann KI Bilder im Stil von Astrid Henn machen?“
entscheidend sein, sondern eher:
„Übernimmt der konkrete Output hinreichend viele geschützte Gestaltungsmerkmale eines konkreten Werks?“
Das ist juristisch viel schärfer.
5. Aber OpenAI hat ein wichtiges Gegenargument: Wer verursacht die Ausgabe?
Hier wird es technisch und juristisch interessant.
OpenAI könnte sinngemäß argumentieren:
ChatGPT speichert kein digitales Exemplar des NEINhorn-Buches, das bei einer Anfrage einfach herauskopiert wird. Das Modell erzeugt probabilistisch einen neuen Output auf Grundlage des Nutzer-Prompts.
Und daraus folgt die nächste Frage:
Wer nimmt die rechtlich relevante Handlung vor – OpenAI, das Modell/System oder der Nutzer, der den Prompt eingibt?
Diese Frage ist keineswegs theoretisch. Beim EuGH ist derzeit die Rechtssache C-250/25, Like Company anhängig. Dort geht es unter anderem ausdrücklich darum, wie urheberrechtlich mit einem LLM-Chatbot umzugehen ist, wenn dessen Antwort mit geschütztem Ausgangsmaterial übereinstimmt – und ob es eine Rolle spielt, dass der Chatbot den Text aufgrund gelernter Muster beziehungsweise Wortvorhersage erzeugt. Das Verfahren ist Stand heute noch anhängig.
Die europäische Rechtslage entwickelt sich also genau an diesem Punkt gerade weiter.
6. Deshalb ist die Formulierung „einfachste Eingaben“ juristisch clever
Das ist für mich eines der interessantesten Details der Pressemitteilung.
Carlsen sagt ausdrücklich, dass bereits einfache Prompts zu den beanstandeten Ergebnissen geführt hätten. Der NDR berichtet ebenfalls, dass nach Angaben von Schumacher-Gebler sehr einfache Abfragen verwendet worden seien.
Warum ist das wichtig?
Stell dir zwei Experimente vor.
Experiment A:
„Schreibe mir exakt Seite 12 des NEINhorn-Buches und bilde das Originalbild möglichst genau nach.“
Dann könnte OpenAI viel leichter argumentieren: Der Nutzer hat gezielt versucht, geschützten Content zu reproduzieren.
Experiment B:
„Erzähl mir eine Geschichte vom NEINhorn.“
Und das System produziert daraufhin selbstständig charakteristische Figuren, Handlungselemente, Illustrationen und womöglich noch ein Carlsen-Impressum.
Dann sieht die Verantwortungsfrage deutlich anders aus.
Deshalb würde ich in einem Prozess sehr genau auf die Original-Prompts und vollständigen Chatverläufe schauen.
7. Das Impressum mit Kling, Henn und Carlsen ist spektakulär – aber nicht unbedingt der stärkste Beweis
Die Geschichte mit dem automatisch erzeugten Impressum ist kommunikativ hervorragend: Laut Carlsen soll ChatGPT Marc-Uwe Kling als Textautor, Astrid Henn für die Illustrationen und Carlsen beim Copyright genannt haben. Schumacher-Gebler hat das gegenüber dem NDR nochmals beschrieben.
Das klingt fast wie ein Eingeständnis der Maschine.
Juristisch würde ich daraus aber nicht schließen:
„ChatGPT weiß also, dass es das Original kopiert.“
Ein Sprachmodell kann solche bibliografischen Zusammenhänge auch aus Informationen über ein bekanntes Buch rekonstruieren. Das beweist für sich genommen keine konkrete Trainingskopie.
Als Gesamtindiz zusammen mit sehr originalnahen Bildern und Texten könnte es dagegen interessant werden.
8. Ein Punkt der Pressemitteilung ist meines Erachtens zu pauschal
Carlsen formuliert:
„Auf Basis der äußerst detailgetreuen Kopien des Originals muss davon ausgegangen werden, dass die Originalwerke […] zum Training […] genutzt wurden und nun als ‚Memorisierung‘ in diesen Modellen enthalten sind.“
Das würde ich juristisch und technisch auseinandernehmen.
Es sind mindestens drei Behauptungen:
A: Das Werk wurde für das Training verwendet.
B: Die Verwendung war rechtswidrig.
C: Das Werk wurde vom Modell memorisiert.
A beweist nicht automatisch B.
Und ein reproduzierbarer ähnlicher Output kann ein Indiz für C sein, beweist aber noch nicht ohne weitere Untersuchung, wie der konkrete Output zustande gekommen ist.
Genau hier dürfte Sachverständigenbeweis beziehungsweise technische Dokumentation sehr wichtig werden.
9. Was könnten Kling, Henn und Carlsen verlangen?
Wenn eine widerrechtliche Urheberrechtsverletzung festgestellt wird, sieht § 97 UrhG insbesondere Beseitigung, Unterlassung und bei vorsätzlicher oder fahrlässiger Verletzung Schadensersatz vor. Bei der Schadensberechnung kann unter anderem auf eine angemessene Lizenzvergütung abgestellt werden.
Das erklärt die Formulierungen der Pressemitteilung: Carlsen verlangt nicht nur Geld, sondern spricht ausdrücklich von Unterlassung, Offenlegung möglicher Missstände und Ersatz des bereits entstandenen Schadens.
Meine Einschätzung des Falls
Ich würde Carlsens Position nicht primär an der großen Frage „Darf man urheberrechtlich geschützte Bücher zum KI-Training verwenden?“ festmachen. Dort gibt es schwierige und teilweise noch ungeklärte Fragen rund um die europäischen TDM-Regeln.
Der möglicherweise stärkere Teil des konkreten Falls ist viel enger:
Kann ein kommerziell angebotenes KI-System nach unspezifischen oder sehr einfachen Prompts wesentliche geschützte Bestandteile eines konkreten Werkes so genau reproduzieren, dass das Ergebnis selbst eine urheberrechtlich relevante Vervielfältigung oder Bearbeitung darstellt – und wenn ja, wer ist dafür verantwortlich?
Falls Carlsen vor Gericht tatsächlich vollständige Chatverläufe vorlegen kann, bei denen einfache, nicht auf Reproduktion optimierte Prompts wiederholt zu sehr originalnahen Texten und Bildern führen, halte ich das für erheblich interessanter als einen bloßen Nachweis, dass NEINhorn-Material irgendwann in Trainingsdaten enthalten war.
Umgekehrt wäre es für OpenAI sehr relevant, wenn sich herausstellen sollte, dass die spektakulären Ergebnisse nur durch sehr spezifisches Prompting, zahlreiche Versuche oder gezielte Bezugnahme auf Originaldetails zustande kamen.
Deshalb wäre mein erstes Beweisstück als Richter nicht das Trainingsdataset.
Es wären die vollständigen Prompts, Outputs und Versuchsprotokolle.
Daran ließe sich beurteilen, wie stark der Fall tatsächlich ist.
Da sowohl das Münchner Verfahren als auch die europäische Rechtsprechung hierzu in Bewegung sind, kann ich die Entwicklung auch weiterverfolgen.
Ende des Dialogs mit ChatGPT
Auf die Aufforderung „Zeichne ein Neinhorn von Carlsen“ lieferte ChatGPT folgendes Ergebnis: